OmniTian 智能知识库平台:系统设计、核心算法与成本优化实践
从「搜—读—写」一体化,到双层缓存与调用瘦身的工程实现
摘要
OmniTian 是一套以知识库为底座、提供「搜—读—写」一体化体验的 AI 知识管理平台。它把文档解析、混合检索、大模型问答、在线文档编辑、多角色智能体与自动化任务收敛在同一个可私有化部署的系统内。
本文分三个部分展开:第一部分给出功能全景与五层架构,说明每个模块的职责边界;第二部分拆解关键算法,包括文档切片、关键词与向量的混合检索、双层缓存、Token 估算与积分计量、模型路由降级、工具裁剪;第三部分建立可复算的成本模型,并用模型服务商账单的实测数据说明:前缀缓存命中率 71.7% 时,输入 token 成本可降至原来的 35.5%(节省 64.5%),叠加应用层答案缓存与调用瘦身后,综合成本进一步下降。
关键词:检索增强生成 · 混合检索 · 前缀缓存 · 答案缓存 · Token 成本 · 知识库
1系统定位与功能全景
系统的设计目标可以归纳为四条硬约束:知识可溯源、回答不编造、成本可控、私有化可部署。前两条决定了检索与提示词的形态,后两条决定了缓存与调度的形态。所有功能模块都围绕这四条约束展开,而不是先堆功能再想成本。
1.1功能矩阵
平台的主导航分为「日常使用」「多角色智能体」「管理与测试」三组。下表按用户价值归类,并标注每个模块的核心实现与关键约束。
表 1 功能矩阵与实现要点
| 模块 | 能力 | 实现要点 | 关键约束 |
| 知识问答 | 流式对话、@知识库检索、联网搜索、图片生成、工具调用、追问建议、停止生成 | 系统提示词 + 历史上下文 + 注入式检索结果;工具清单按稳定条件动态组装;回答落库后置为 done,再异步补追问 | 答案必须标注来源文档;检索不到时明确告知,不允许编造 |
| 知识文库 | PDF / DOCX / TXT / MD / XLSX / PPTX 上传解析、自动摘要与标签、分块索引、回收站 | 自研 OOXML 与 PDF 文本抽取;按 800 字切片、100 字重叠;摘要与标签由模型生成后落库 | 解析失败的文档不进入检索;带毒/异常文件标记后排除 |
| 我的云盘 | 在线编辑 DOCX 与 XLSX、图片预览、文件分享、缩略图 | DOCX 采用「整包复制 + 只替换 word/document.xml」;XLSX 采用「整表集重建」;图片走流式输出零落盘 | 保存后必须同步只读视图,避免「保存成功但页面还是旧内容」 |
| 提示词市场 | 提示词模板的浏览、收藏与一键套用 | 模板参数化,套用时填充变量后进入对话 | 模板不携带用户私有数据 |
| 自动化任务 | 定时任务、Webhook 触发、任务编排 | 统一 cron 入口 + 任务表;执行结果写入通知中心 | 单任务超时与重试上限;失败不静默 |
| 多角色智能体 | Excel / Word / PPT / 会议 / 数据分析 / 邮件 / 翻译 / 数字人播报 | 角色控制台复用同一套工具与模型网关,仅切换系统提示词与工具子集 | 角色权限独立授权,按角色裁剪工具 |
| 引擎中心 | 模型接入、候选顺序、积分额度、向量服务、MCP 与自定义工具 | 模型表区分 chat / image / video;候选过滤后按顺序降级 | 只有 unlimited=1 不限额度;额度为 0 且非不限即禁用 |
| 安全与运营 | RBAC 权限、登录风控、操作日志、运营看板、测试平台 | 权限取「角色 ∪ 个人 ∪ 部门」的并集;关键动作统一写 operation_logs | 知识库检索按可访问范围做行级过滤 |
1.2技术栈与部署形态
系统刻意选择了扁平单体:203 个 PHP 文件全部位于同一目录,模块之间以前缀区分(ai_、kb_、cloud_、agent_、webtest_),没有 Composer 依赖注入,也没有前端构建步骤。前端是服务端渲染 + PJAX 局部刷新 + 骨架屏,交互逻辑用原生 JavaScript 写在页面内。
表 2 技术选型与理由
| 层面 | 选型 | 选择理由与代价 |
| 运行时 | PHP 8(严格类型) | 与主流虚拟主机/宝塔环境兼容,部署成本低;代价是没有常驻进程,长任务必须转异步 |
| 数据 | MySQL + PDO 预处理 | 事务与行级锁足够;全文检索未依赖 FULLTEXT,改用 LIKE + 应用层打分,避免分词器差异 |
| 前端 | 原生 JS + PJAX + 骨架屏 | 首屏直出、切换无白屏;代价是事件必须做 document 级委托,避免重复绑定 |
| 异步 | 作业表 + worker + daemon | 模型往返可能超过 120 秒,必须与 HTTP 请求解耦;worker 的心跳用于防止任务被误判卡死而重跑 |
| 存储 | 本地文件 + 数据库元数据 | 零外部依赖,便于私有化;大文件与图片走流式读写,不整段载入内存 |
| 可选增强 | 向量服务、联网搜索、MCP | 全部可关闭。关闭后系统退化为关键词检索 + 精确缓存,功能仍完整 |
2总体架构
系统分为五层。自上而下是请求的入口、业务编排、AI 编排、模型与工具、数据与存储。层与层之间只通过函数调用与数据库表通信,没有 RPC,因此一次请求的完整链路可以在单个进程内读完。
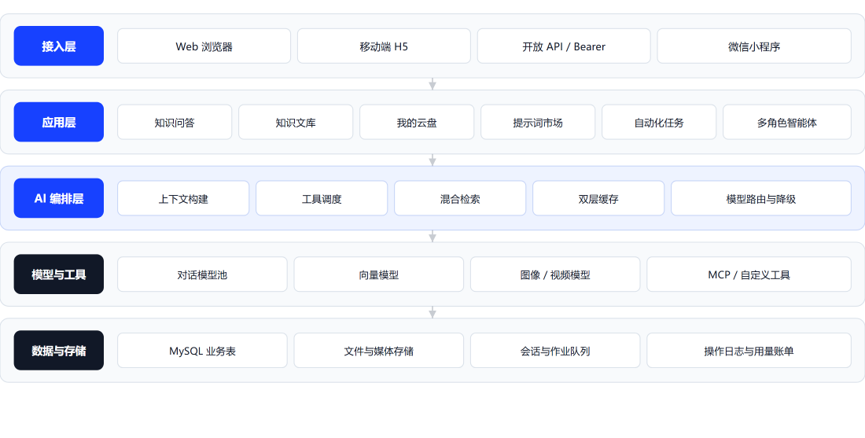
图 1 OmniTian 五层架构。蓝色为业务与编排层,深灰为资源层;同层模块可平级替换,跨层只通过函数与数据表耦合。2.1一次问答的完整生命周期
同步与异步的分界线非常明确:凡是需要调用大模型的动作都不在 HTTP 请求里完成。前端提交问题后立即拿到一个作业号,随后通过轮询读取增量内容;服务端的 worker 负责真正的模型往返、工具执行与流式落库。
表 3 请求生命周期与责任划分
| 步骤 | 动作 | 实现 | 设计意图 |
| 1 | 鉴权与配额校验 | Session 或 Bearer Token;读 user_ai_quota | 额度不足时直接拦截,不产生模型调用 |
| 2 | 上下文组装 | 系统提示词 + 历史消息 + @知识库 / 联网 / 附件注入 | 稳定内容在前、易变内容在后,为前缀缓存创造条件 |
| 3 | 缓存查询 | 先精确键,再语义相似度;命中即返回 | 命中轮次完全跳过模型,成本为零 |
| 4 | 提交异步作业 | 写 ai_async_jobs,返回 job_id | HTTP 请求不被长耗时阻塞 |
| 5 | 模型调用与工具循环 | 最多 8 轮工具往返,每轮刷新作业心跳 | 心跳防止任务被误判卡死而重复执行 |
| 6 | 落库并置 done | 先保存消息、标记完成,再补追问与记忆 | 文字早已生成完毕,不应让用户等追问 |
| 7 | 计量与审计 | ai_log_token_usage 统一扣减积分并写日志 | 扣减入口唯一,避免多处重复计费 |
| 工程取舍 第 6 步的顺序是本系统一个容易被忽略的体验优化:追问建议与长期记忆提炼各自都要再调用一次大模型,合计 5–15 秒。如果它们排在「标记完成」之前,用户会看到文字早已停止增长、按钮却迟迟不恢复。把主回答先交付、副作用后置,并用配置开关默认关闭这两个附带调用,同时解决了体感慢与成本高两个问题。 | |||
3核心功能的设计取舍
3.1知识库:解析、切片、索引
文档进入系统后要经过四个阶段:文本抽取、切片、摘要与标签、向量化。每个阶段都可能失败,因此每一步都写状态;只有走到 ready 的文档才会被检索命中。抽取层不使用第三方库,而是直接解包 OOXML 与 PDF:DOCX 走段落遍历、XLSX 读共享字符串表、PPTX 从 ppt/slides 读取、PDF 解 FlateDecode 流。
表 4 各格式的解析策略
| 格式 | 解析方式 | 产物 | 注意事项 |
| DOCX | 遍历 word/document.xml 段落节点 | 纯文本 + 内嵌图片引用 | 不能用「正则匹配段落」的粗暴方式,会丢表格与嵌套结构 |
| XLSX | 读 sharedStrings.xml 与各工作表 XML | 按行拼接的文本 | 数字与日期需按单元格类型还原 |
| PPTX | 从 ppt/slides 逐页取文本框 | 按页分段的文本 | 基础目录必须指向 slides,否则取不到内容 |
| 解析内容流,FlateDecode 用带 zlib 头的解压 | 文本 + 图片清单 | 用错解压函数会直接得到空文本 | |
| MD / TXT | 直接读取,Markdown 保留结构标记 | 原文 | 渲染时图片规则必须排在链接之前 |
| 网页导入 | 抓取 HTML 后提取标题与正文 | 标题 + 正文 | 需剔除导航、脚本与样式噪声 |
切片参数是 800 字 / 100 字重叠。800 字大约对应 800 个 token(中文按一字一 token 估算),既能让单个片段语义完整,又能保证 TopK 拼接后不撑爆上下文。100 字重叠用于避免答案恰好被切断在片段边界。
3.2知识问答:检索增强 + 工具调用
问答不是「把文档全塞给模型」,而是让模型自己决定是否需要检索。系统向模型暴露 list_knowledge_bases、search_knowledge_base、list_documents_in_kb、get_document_content 等工具,由模型在多轮工具循环中按需调用;用户显式写 @知识库名 时,系统则直接预检索并作为 system 消息注入,省掉一次工具往返。
这种做法有两个直接收益:一是按需付费,闲聊类问题不会触发检索;二是可溯源,检索结果带文档标题与知识库名,回答可以标注来源。
3.3云盘在线编辑:直接改写 Office 文件
在线编辑最容易踩的坑是「另存为一个新文件」,导致图片、样式、批注全部丢失。本系统采用两种互补策略:
- DOCX —— 整包复制,只替换正文。保留原始压缩包内的样式、主题、页眉页脚与媒体文件,仅重写 word/document.xml;图片按关系 ID 回填,保证图文混排不丢图。
- XLSX —— 整表集重建。复用原有的 sheetId 与关系目标,重建工作表、样式表、合并单元格与列宽;同时清理多余的 worksheet、失效的关系与 calcChain.xml,避免 Excel 打开时报「内容有问题」。
易错点 保存接口返回成功,不等于用户看到的就是新内容。退出编辑态后,只读视图必须用刚保存的数据重新渲染;否则用户会坚定地认为「保存没生效」。同理,此类页面必须发送 Cache-Control: no-store,并让前端路由缓存失效。
3.4多角色智能体与自动化
八个角色(Excel、Word、PPT、会议、数据分析、邮件、翻译、数字人)并不维护八套代码,而是复用同一套模型网关与工具层,只在三处产生差异:系统提示词、可用工具子集、输出渲染器。自动化任务则把「触发条件 → 动作序列 → 结果通知」抽象为任务表,由统一 cron 入口驱动。
4关键算法
本节按数据流顺序展开:先讲文档如何变成可检索的片段,再讲问题如何找到片段,最后讲答案如何被复用。
4.1混合检索:关键词兜底,向量增效
纯向量检索在专有名词、型号、编号上容易失手;纯关键词检索又无法处理同义改写。系统采用双路召回 + 加权融合:关键词路负责精确命中,向量路负责语义泛化,任一路单独命中的片段都会被保留。
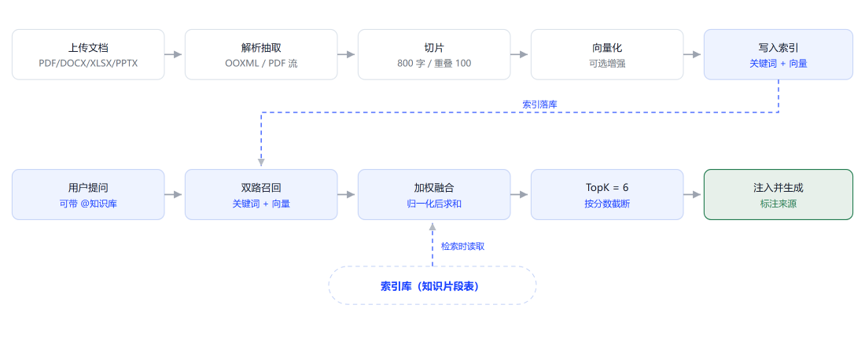
图 2 文档入库(上)与检索生成(下)。虚拟线表示离线索引与在线检索之间的数据依赖。关键词路先把问题切成中文二元组(bigram),最多取 24 个 token,再用 LIKE 召回并按「命中 token 数」打分。bigram 的好处是不依赖分词词典,型号、缩写、生僻词都能命中;代价是召回偏宽,需要向量路与 TopK 截断来收敛。
向量路把问题编码为向量,与候选片段计算余弦相似度。两路分数各自归一化后加权求和:
| score(d) = w · cos(q, d) + (1 − w) · kwNorm(d) 其中kwNorm(d) = kw(d) / maxd' kw(d'),w 为可配置的向量权重 |
只出现在一路的片段不会被丢弃,缺失的一路按 0 分处理。这样即使向量服务未启用,检索也能退化为纯关键词模式,系统功能不残缺。
表 5 检索参数与取值
| 参数 | 取值 | 作用 |
| 切片长度 | 800 字 | 约 800 token,兼顾语义完整与上下文预算 |
| 切片重叠 | 100 字 | 避免答案被切断在片段边界 |
| 关键词 token 上限 | 24 | 控制 SQL 长度,同时保留足够召回面 |
| 候选扩展倍数 | 3×(且 ≥ limit+6) | 向量启用时先多召回,再由融合排序截断 |
| 最终片段数 TopK | 6 | 平衡答案覆盖度与输入 token 成本 |
| 向量权重 | 可配置 | 偏向精确匹配时调低,偏向语义泛化时调高 |
4.2双层缓存:先精确,后语义
缓存是成本优化的主战场。系统在应用层与模型网关层各设一道缓存,二者互不替代:应用层缓存的是完整答案,网关层缓存的是提示词前缀。
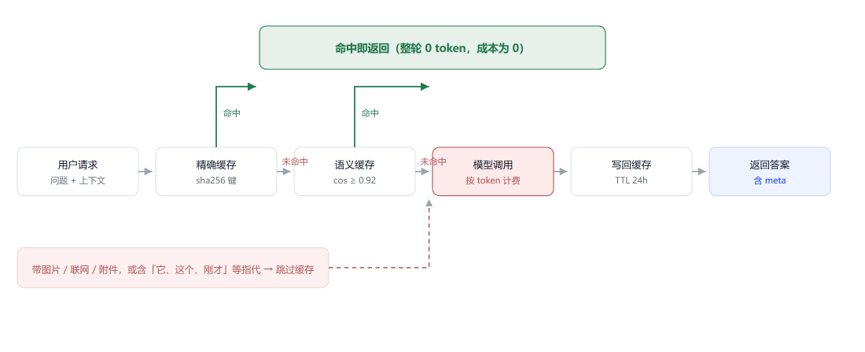
图 3 缓存决策路径。两道缓存都是「命中即短路」,未命中才进入计费调用;带上下文依赖的问题不参与缓存复用。精确缓存的键由四元组哈希得到,模型标识参与哈希,保证不同模型的回答不串用:
| // 键:用户 + 角色 + 归一化问题 + 模型(含联网开关) key = sha256( userId | role | lower(trim(question)) | modelId:model:ws ) // 上下文隔离:最近 2 条消息的摘要指纹 digest = md5( json( last2(context) ) ) |
为了让缓存「宁可少命中,也不答错」,系统加了三道闸:
- 上下文指纹。同一句话在不同对话上下文中含义不同,因此写入时记录最近两条消息的指纹,供语义匹配时比对。
- 指代拦截。问题长度小于 6 字,或包含「它 / 这个 / 刚才 / 继续」等 20 余个指代词时,直接跳过缓存。
- 阈值约束。语义匹配只在同用户、同角色、同模型、同嵌入模型的候选集内进行,余弦相似度必须 ≥ 0.92 才算命中。
表 6 缓存设计参数
| 参数 | 取值 | 说明 |
| 缓存表 | ai_response_cache | 键唯一索引,正文与 meta 分列存储 |
| 精确键 | SHA-256 | 四元组含模型标识,天然隔离多模型 |
| 默认 TTL | 86,400 秒 | 24 小时;写入时随机触发过期清理(2% 概率,每次最多 500 条) |
| 语义阈值 | 0.92 | 低于阈值宁可回源,避免「看似命中、实则答偏」 |
| 语义候选上限 | 30 条 | 按时间倒序取最近候选,控制比对开销 |
| 上下文窗口 | 最近 2 条 | 指纹计算范围,兼顾隔离性与稳定性 |
| 依赖前置 | 向量服务 | 未启用时语义缓存整体不生效,仅走精确匹配 |
| 跳过条件 | 图片 / 联网 / 附件 / 指代 | 这些请求的答案不具备可复用性 |
为什么两道缓存不冲突 应用层缓存命中的请求根本不会到达模型网关,所以不产生任何 token;未命中的请求才进入网关,此时前缀缓存负责把「系统提示词 + 工具定义 + 历史消息」这段稳定前缀按 1/10 价格计费。二者是串联关系,收益相乘而非相加。
4.3Token 估算与积分计量
计费必须可解释,因此系统不依赖第三方分词器,而是用一条可复算的近似规则:中日韩字符按 1 字 ≈ 1 token,其余字符按 4 字符 ≈ 1 token。偏保守的估算可以避免低估上下文长度而撞上模型窗口。
| T(text) = CJK + ceil( (len − CJK) / 4 ) 积分credits = ceil( totalTokens / 1000 ) |
表 7 计量与额度规则
| 对象 | 计量方式 | 规则 |
| 文本对话 | 按 token | 每 1000 token 计 1 积分,向上取整 |
| 图片生成 | 按张 | 每张固定积分,不按 token 折算 |
| 视频 / 数字人 | 按次 | 固定积分,成本显著高于文本 |
| 默认月额度 | 5,000 积分 | 月初自动重置;unlimited=1 是唯一不限额度标记 |
| 额度耗尽 | 拦截 | 额度为 0 且非不限即禁用;80% 与 100% 各提醒一次 |
| 扣减入口 | 唯一 | 只在 ai_log_token_usage 扣减,避免重复计费 |
4.4模型路由与降级
模型候选按配置顺序排列,只保留类型为 chat 的模型参与对话路由。调用失败时自动切换下一个候选,最多尝试 3 次,并记录降级日志。这样单家服务商抖动不会直接变成用户可见的失败,但也避免了无限重试放大成本。
4.5工具裁剪:只按稳定条件,不看问题内容
工具定义本身也占 token。系统在组装工具清单时做静态裁剪,判断依据全部是稳定条件(权限、开关、配置),而不是对用户问题的猜测——后者会让缓存键失效、行为不可预测。
表 8 工具裁剪规则
| 条件 | 结果 | 依据 |
| 未开启联网搜索 | 不下发联网工具 | 请求级开关 |
| 未配置图像模型 | 不下发绘图工具 | 模型配置 |
| 无代码沙箱权限 | 不下发代码执行工具 | RBAC 权限 |
| 用户无自动化任务 | 移除任务查询/运行工具 | 数据状态 |
| 用户未绑定邮箱 | 移除邮件工具 | 账号状态 |
| MCP 分组未启用 | 不合并该组工具 | 分组配置 |
5成本模型与优化路径
大模型调用的账单由两部分构成:输入 token 与输出 token。输入 token 随上下文长度线性增长,且在知识库问答中通常远大于输出,因此优化的重心在输入侧。
5.1成本公式
| Cturn = Tin · Pin · F + Tout · Pout 其中F = r · p + (1 − r),r 为前缀命中率,p 为缓存读价系数 |
当缓存读价为输入价的 1/10(即 p = 0.1)时,F 就是「输入成本指数」:无缓存时 F = 1,全部命中时 F = 0.1。
5.2网关前缀缓存:稳定前缀的价值
前缀缓存的生效前提是「前缀足够长且足够稳定」。系统的消息顺序经过刻意设计:系统提示词 → 工具定义 → 历史消息 → 检索结果 / 附件 → 本轮问题。真正易变的内容被放在最后,前面几百到几千 token 的公共部分可以跨请求复用。
表 9 网关账单两个统计窗口的实测命中
| 统计窗口 | 缓存命中 | 未命中 | 命中率 | 输入成本指数 F |
| 11:00–12:00 | 39,552 | 22,403 | 63.8% | 0.426 |
| 12:00–13:00 | 50,432 | 13,198 | 79.3% | 0.286 |
| 合计 / 加权 | 89,984 | 35,601 | 71.7% | 0.3547 |
| F = 0.717 × 0.1 + 0.283 × 1 = 0.3547 节省率1 − 0.3547 = 64.5% | ||||
注:命中/未命中为账单快照中的 Input(Cache hit) 与 Input(Cache miss) 合计,属人工取样窗口,不代表全天;缓存读价按 1/10 假设,实际以服务商定价为准。
5.3应用层答案缓存:整轮归零
前缀缓存省的是「单价」,答案缓存省的是「整轮」。命中一次,输入与输出都不再发生,等价于把该轮成本直接抹掉。其收益用反事实方式估算:
| savedtokens = H × avgmiss(Tin + Tout) savedcost = H × avgmiss(C) 规避率R = savedcost / (spentcost + savedcost) |
其中 H 为命中次数,avg_miss 取未命中轮次的真实均值。系统直接复用真实均值而不是拍一个常数,是为了让估算随提问长度与模型单价自动变化。
需要如实说明一点:精确命中的收益会随时间衰减。上线初期大量重复问被消化,命中率较高(某 30 天窗口实测 15.19%);进入稳定期后新增问题占多数,命中率回落到 6%–7% 量级(另一窗口 6.58%)。这不是系统退化,而是缓存语料饱和的正常曲线。语义缓存正是为延缓这条曲线而设计的。
5.4调用瘦身:一轮从 3 次到 1 次
相比缓存,更彻底的做法是「本来就不调用」。系统把追问建议与长期记忆提炼改为默认关闭的附带调用。此前每轮问答实际产生 3 次模型请求(主回答 + 追问 + 记忆),现在稳定为 1 次;命中缓存时为 0 次。
表 10 每轮模型调用次数的变化
| 场景 | 优化前 | 优化后 | 降幅 |
| 未命中缓存 | 3 次 | 1 次 | −66.7% |
| 命中缓存 | 1 次(追问) | 0 次 | −100% |
| 长任务(含工具) | 3 + 工具轮 | 1 + 工具轮 | 附带调用归零 |
5.5敏感性分析
前缀命中率与缓存读价是两个不确定量。下表给出不同组合下的输入成本节省率,便于在服务商调价或业务变化时快速估算。
表 11 输入成本节省率(%)的敏感性
| 前缀命中率 r | 读价 0.05× | 读价 0.10× | 读价 0.20× |
| 40% | 38.0% | 36.0% | 32.0% |
| 55% | 52.3% | 49.5% | 44.0% |
| 71.7%(实测) | 68.1% | 64.5% | 57.4% |
| 85% | 80.8% | 76.5% | 68.0% |
计算式:节省率 = 1 − [r·p + (1 − r)]。读价越低、命中率越高,边际收益越明显;但当 r 接近 1 时,继续提升命中率的绝对收益递减。
5.6综合效果
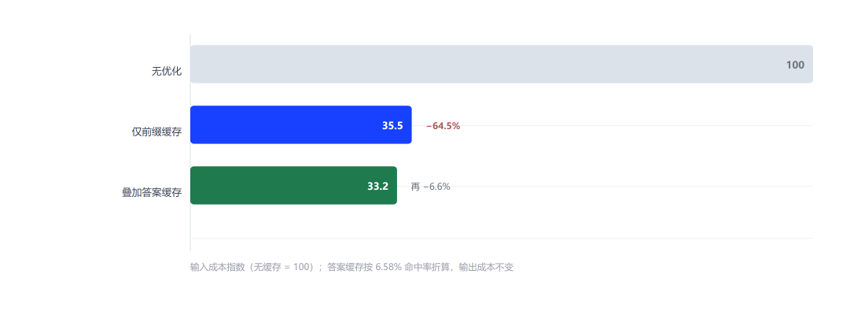
图 4 输入成本指数的逐级下降。前缀缓存贡献主要降幅,答案缓存再消掉一部分整轮调用。表 12 三项优化的作用点与效果
| 优化手段 | 作用点 | 效果 | 前置条件 |
| 网关前缀缓存 | 输入 token 单价 | 输入成本 ×0.355 | 前缀稳定、服务商支持 |
| 应用层答案缓存 | 整轮调用次数 | 命中轮次成本归零 | 问题可复用、无上下文依赖 |
| 调用瘦身 | 每轮请求次数 | 3 次 → 1 次 | 关闭附带生成开关 |
| 工具裁剪 | 工具定义 token | 按权限与配置缩减 | 条件稳定、可预测 |
| TopK 控制 | 检索注入 token | 上限 6 个片段 | 检索质量足够 |
6工程边界与风险
6.1缓存正确性优先于命中率
缓存最怕的不是不命中,而是「看起来命中、其实答错」。系统在四个位置设了防线:模型标识进哈希、上下文取指纹、指代词直接跳过、语义阈值 0.92。任何一项被放宽,都会以「答案莫名其妙」的形式暴露给用户,代价远高于省下的那点 token。
6.2权限必须落到检索层
知识库的可见范围不是在前端隐藏入口,而是在 SQL 里做行级过滤:用户可访问的知识库 ID 集合先算出来,再作为 IN 条件参与检索。管理员的「全部可见」与普通用户的「角色 ∪ 个人 ∪ 部门」走同一套函数,避免两套逻辑漂移。
6.3已知边界
- 语义缓存依赖向量服务。未配置时只走精确匹配,命中率会明显下降,但功能不受影响。
- 命中率会自然衰减。语料越用越「新」,重复问题占比下降,这是缓存的固有曲线,需要靠语义匹配与提示词复用延缓。
- 前缀缓存不可控。是否命中、如何计费由服务商决定,本系统只能通过「稳定内容前置」提高概率。
- 账单口径是抽样。网关命中率来自账单窗口快照,不是全量实时埋点;用于趋势判断可靠,用于精确核算需谨慎。
7结语
这套系统的核心并不在某个单点算法,而在于把「检索、缓存、计量、调度」四条链路对齐到同一个成本模型上:检索决定注入多少 token,缓存决定是否调用,计量决定如何归因,调度决定调用几次。任何一环缺失,成本都会从别处漏出去。
从结果看,前缀缓存把输入单价压到约三分之一,答案缓存消掉一部分整轮调用,调用瘦身把每轮请求降到一次。三者叠加,才构成「可用且可负担」的 AI 知识库。对私有化部署而言,这种可解释、可复算的优化路径,比任何单次调优都更有价值。
附录 A关键参数速查
表 13 系统关键参数一览
| 参数 | 取值 | 所属环节 |
| 切片长度 / 重叠 | 800 / 100 字 | 文档入库 |
| 检索 TopK | 6 | 混合检索 |
| 关键词 token 上限 | 24 | 关键词召回 |
| 缓存 TTL | 86,400 秒 | 应用层缓存 |
| 语义命中阈值 | 0.92 | 语义缓存 |
| 语义候选上限 | 30 条 | 语义缓存 |
| 上下文指纹窗口 | 最近 2 条 | 缓存隔离 |
| 每积分 token 数 | 1,000 | 额度计量 |
| 默认月额度 | 5,000 积分 | 额度计量 |
| 模型降级尝试次数 | 3 | 模型路由 |
| 工具循环上限 | 8 轮 | 工具调度 |
| 附件注入上限 | 6,000 字 | 上下文构建 |
本文所述参数与公式均取自系统当前实现;网关命中率来自模型服务商账单的两个统计窗口,应用层指标随统计周期动态变化,页面会实时读取运行日志重新计算。文中涉及的成本结论为基于真实均值的估算,不构成账单承诺。